Software ontwikkelen met behulp van AI en rekening houden met AVG, NIS2 en DORA compliance
Zodra je een coding agent aan je codebase hangt, raak je drie regimes tegelijk. Niet omdat AI apart gereguleerd is (de AI Act is een verhaal op zich), maar omdat AI-tooling bestaande regels raakt op plekken waar je ontwikkelstraat er nooit eerder mee te maken had. Je stuurt code naar een derde partij, je haalt afhankelijkheden binnen die niemand handmatig gekozen heeft, en je verandert wie of wat een productiewijziging voorstelt.
Dit artikel gaat over de engineeringkant. Het is geen juridisch advies; voor de precieze reikwijdte in jouw situatie heb je je eigen jurist of compliance officer nodig.
Eerst de namen, en wat er verandert zodra AI meedoet
Hier zit meteen verwarring, en die is bij ZEN extra voelbaar omdat wij beide betekenissen dagelijks gebruiken.
- AVG: de Nederlandse implementatie van de GDPR. Gaat over persoonsgegevens: welke je verwerkt, waarom, en waar ze terechtkomen.
- NIS2: Europese richtlijn over cyberbeveiliging voor essentiële en belangrijke entiteiten. Legt de nadruk op risicobeheer, ketenverantwoordelijkheid en het melden van incidenten. De Nederlandse omzetting heeft vertraging opgelopen; check de actuele stand voordat je op een datum plant.
- DORA: hier twee dingen. De Digital Operational Resilience Act geldt voor de financiële sector en gaat over ICT-risico’s en je afhankelijkheid van externe ICT-dienstverleners. En DORA-metrics zijn de vier leverstatistieken uit DevOps-onderzoek. Ze hebben niets met elkaar te maken, en in een vergadering waar zowel compliance als engineering zit, is dat vijf minuten uitleg waard.
De regels zijn niet nieuw. Wat verandert, is waar ze raken. Voorheen liep je code van je repository naar je pipeline naar productie, allemaal binnen grenzen die je zelf had getrokken. Met een coding agent gaat er een deel van die code, en soms de context eromheen, naar een dienst die je niet beheert. Dat is geen ramp, maar het is wel een verwerking en een afhankelijkheid, en beide moet je kunnen benoemen.
AVG: waar gaat je context naartoe?
De kernvraag is niet “gebruiken we AI” maar “wat sturen we mee”.
Code zelf is meestal geen persoonsgegeven. Maar de context eromheen kan dat wel zijn: een testfixture met echte klantnamen, een stack trace met e-mailadressen, een databasedump waar iemand snel iets in wilde opzoeken, een logfile die je erbij plakt om een bug uit te leggen.
Wat je praktisch wilt weten:
- Welke tooling stuurt wat naar buiten? IDE-plugins, CI-integraties en agents verschillen sterk in wat ze meesturen.
- Waar staat de verwerking? Regio en subverwerkers doen ertoe, net als bij elke andere clouddienst.
- Wordt jouw invoer gebruikt voor training? Dat is bij zakelijke abonnementen meestal uit te zetten, maar het is een bewuste keuze die iemand moet maken en vastleggen.
- Staan die tools in je verwerkingsregister? Als AI-tooling breed gebruikt wordt maar nergens genoteerd staat, is dat het eerste gat dat opvalt.
NIS2: je AI-leverancier zit nu in je keten
NIS2 legt veel nadruk op de beveiliging van je toeleveringsketen. Een AI-codeerassistent die schrijftoegang heeft tot je repository’s, of die in je pipeline draait, is onderdeel van die keten. Dat betekent dat de vragen die je al aan andere leveranciers stelt, hier ook gelden: welke toegang heeft dit, wat gebeurt er bij een storing of een compromittering aan hun kant, en hoe merken wij dat?
Er komt één ding bij dat specifiek is voor AI-tooling: afhankelijkheden die niemand gekozen heeft. Als een agent een package voorstelt en dat komt door de review, dan is er een leverancier aan je keten toegevoegd door een model. Dat is precies het soort beslissing dat NIS2 zichtbaar wil hebben, dus laat je dependency-scanning en je goedkeuringsroute voor nieuwe packages niet ongemoeid als het volume omhoog gaat.
DORA: aantoonbaarheid, niet alleen beleid
Val je onder de Digital Operational Resilience Act, dan verschuift de lat van “we hebben beleid” naar “laat maar zien”. Je moet kunnen laten zien welke ICT-diensten van derden je gebruikt, welke risico’s daaraan hangen en hoe je systeem zich houdt als er iets misgaat. Een AI-codeerdienst die betrokken is bij het maken van je productiecode, hoort in dat overzicht thuis.
De praktische consequentie is documentatie die niet los van je systeem staat: welke tooling betrokken was bij een wijziging, wie hem heeft goedgekeurd, en dat je controles daadwerkelijk gedraaid hebben. Dat is geen extra administratie als je het uit je pipeline haalt, en een hoop werk als je het achteraf met de hand moet reconstrueren.
Wat je inricht, en waarom het engineeringwerk is
Vier dingen die alle drie de regimes tegelijk bedienen, en die geen van drieën echt duur zijn:
- Leg vast welke AI-tooling waar draait en wat hij mag. Eén overzicht, met toegang en verwerkingslocatie erbij. Dit is het document dat je bij elke audit als eerste nodig hebt.
- Markeer AI-ondersteunde wijzigingen. Een vlag op PR-niveau volstaat. Het maakt zowel je risicogesprek als je effectmeting mogelijk, en zonder is beide giswerk.
- Automatiseer je controles in de pipeline. Dependency-scanning, secret-detectie, policy-checks op infrastructuur. Als de hoeveelheid code omhoog gaat, is dit het enige wat meeschaalt; handmatige review doet dat niet.
- Bewaar het bewijs dat die controles gedraaid hebben. Want “we scannen altijd” is geen antwoord, en een pipelinelog is dat wel.
AI-tooling introduceert zelden een nieuw regime. Het verplaatst bestaande verplichtingen naar je ontwikkelstraat: AVG gaat over wat je meestuurt, NIS2 over wie er in je keten zit, inclusief de afhankelijkheden die een model heeft voorgesteld, en DORA over of je het kunt aantonen.
Alle drie komen ze op hetzelfde uit: weten wat er in je pipeline gebeurt en dat kunnen laten zien. Wie dat als compliance-oefening behandelt, bouwt er een aparte administratie omheen die achterloopt zodra de tweede agent aanstaat. Wie het als engineeringwerk behandelt, haalt het bewijs uit de pipeline zelf en heeft het gratis. Ik zou geen coding agent breed uitrollen voordat dat tweede staat, en hoe je dat in je cloudomgeving inricht is precies waar wij bij cloud-consultancy mee beginnen.
Alles of Niets, Katapulteer naar de Cloud
Transformeer je softwareorganisatie naar een cloud-native onderneming
AI consultancy
AI inzetten waar het echt scheelt, met de verantwoordelijkheid bij mensen.
Lees ook:
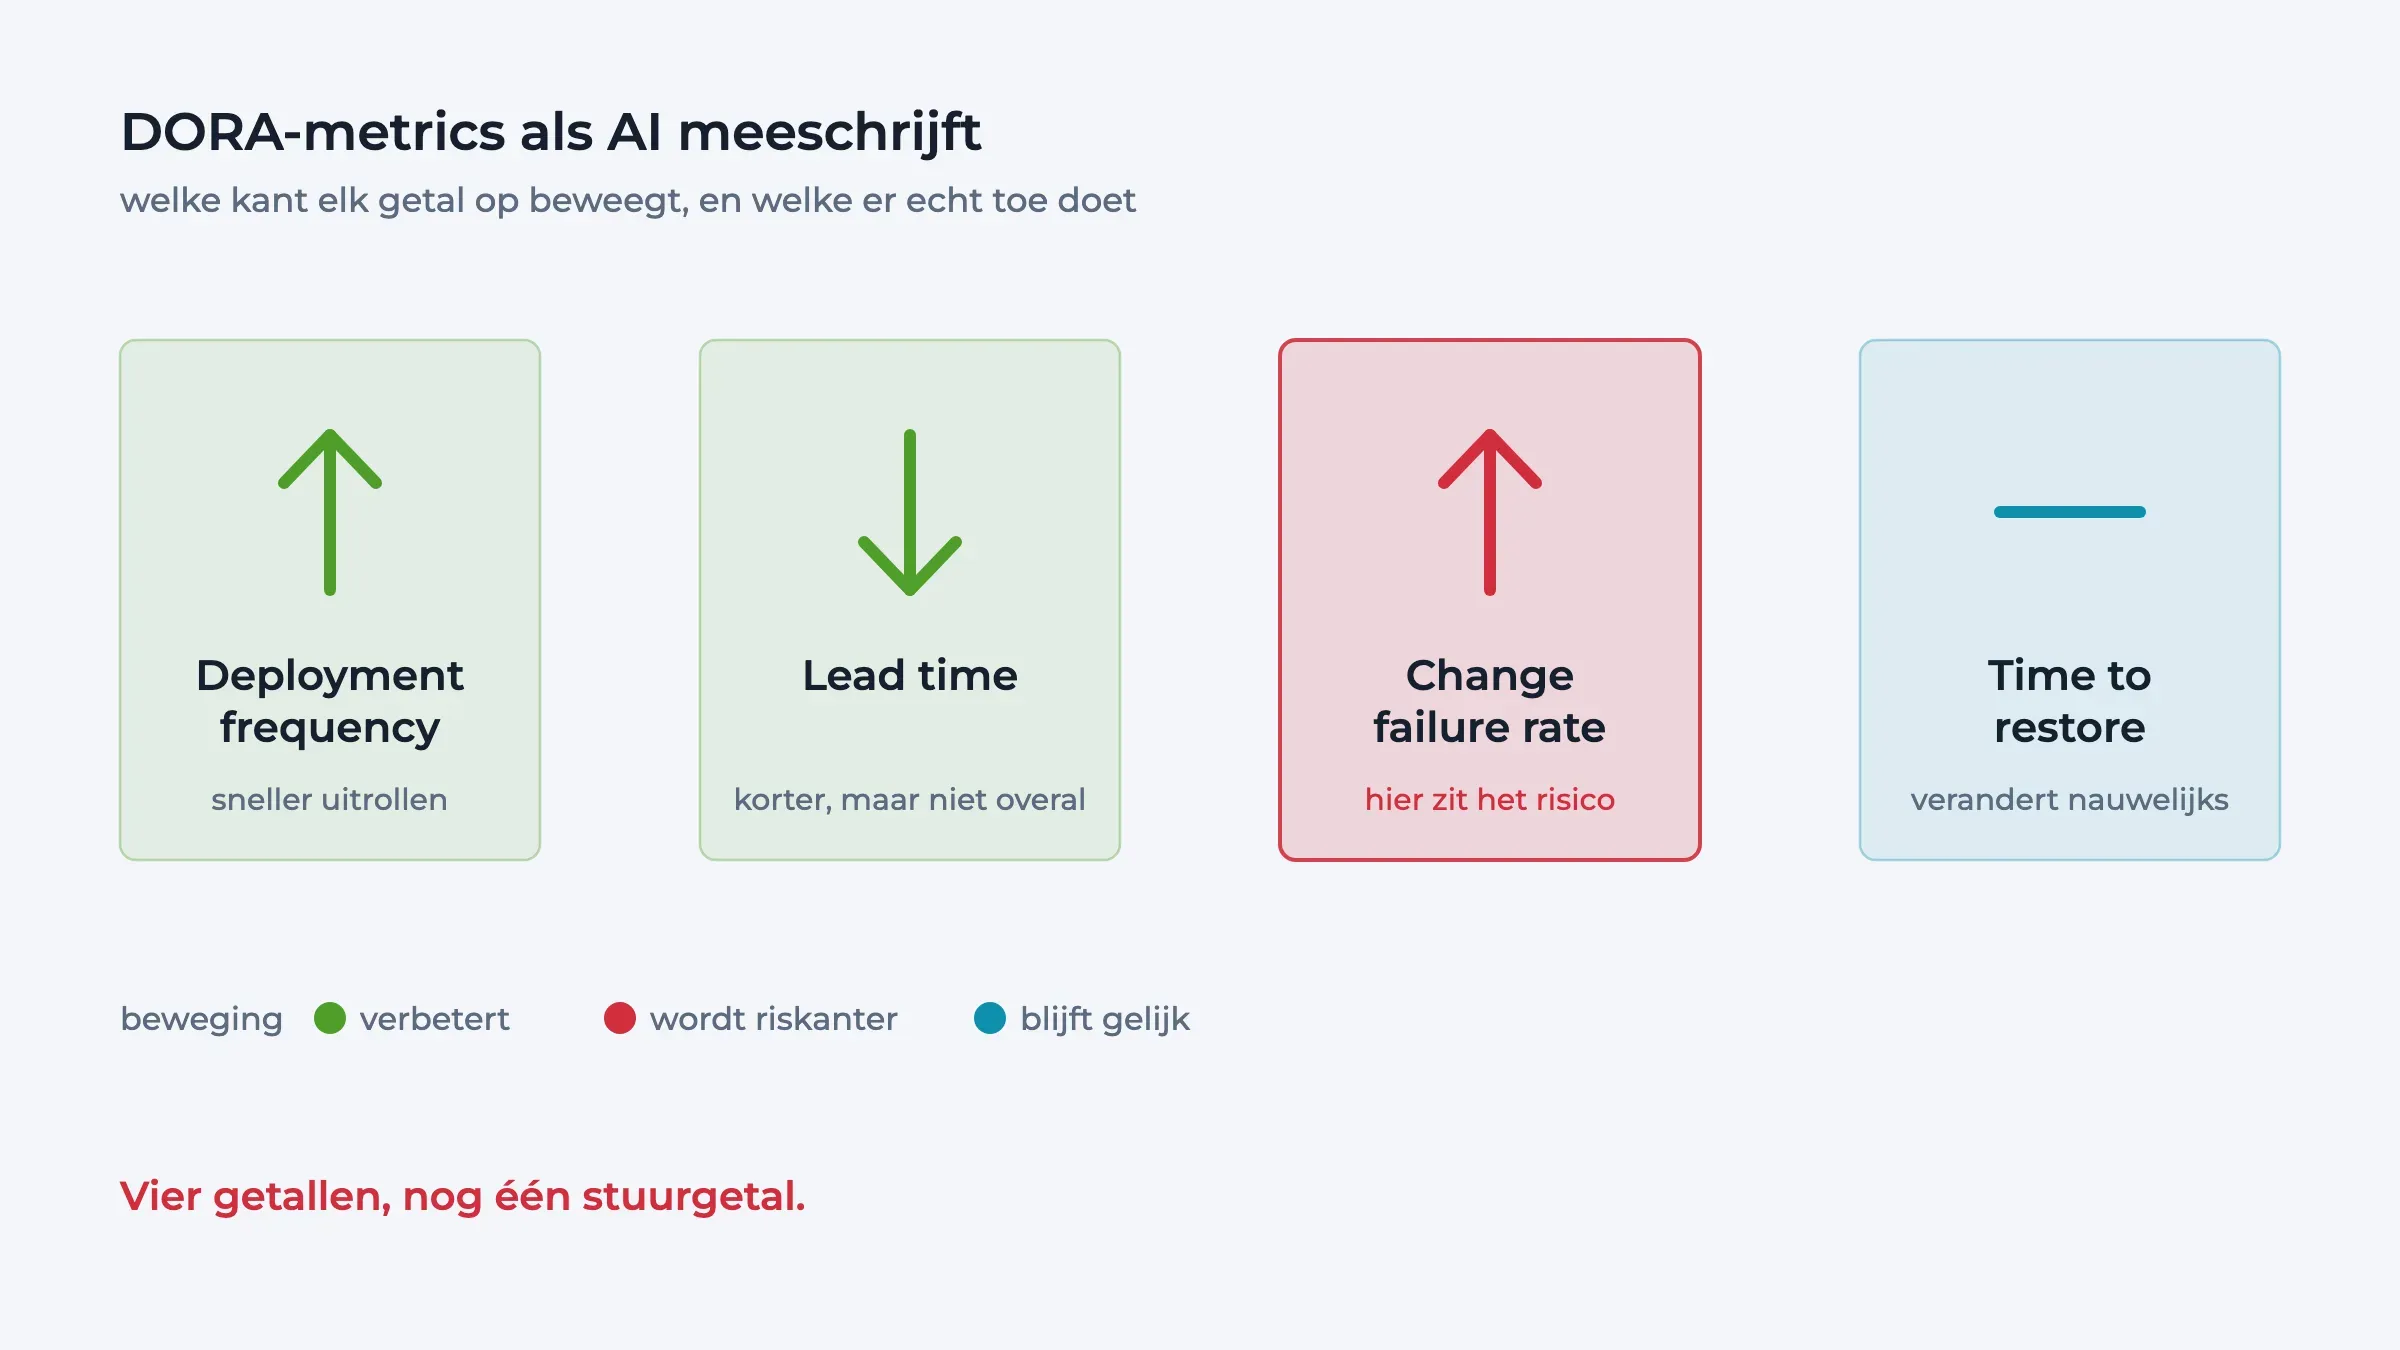
DORA-metrics lezen als AI de helft van je commits schrijft
Je DORA-dashboard toont nog steeds dezelfde vier getallen. Alleen betekenen ze niet meer hetzelfde. Zodra een flink deel...
In 1988 legde een student een tiende van het internet plat. Wat deden we daarna?
In november 1988 schreef een student aan Cornell een programmaatje dat moest tellen hoeveel computers er aan het interne...
OpenAI's AI-agents braken in bij een ander bedrijf. Waarom noemen we dat opeens een complot?
OpenAI's AI-agents braken deze zomer in bij Hugging Face, een ander AI-bedrijf. Volgens Dwarkesh Patel was het een AI-be...
Een AI-abonnement van 200 dollar levert 14.000 dollar aan rekenkracht op. Maar klopt die som?
Een ChatGPT Pro-abonnement van 200 dollar zou 14.000 dollar per maand aan rekenkracht opleveren. Zo gaat de screenshot r...
AI-gegenereerde infrastructuurcode reviewen: waar je écht naar moet kijken
Applicatiecode die fout is, gaat meestal stuk. Infrastructuurcode die fout is, werkt. En dat is precies het probleem. Ee...
Wat dertig minuten wachten per engineer per dag echt kost
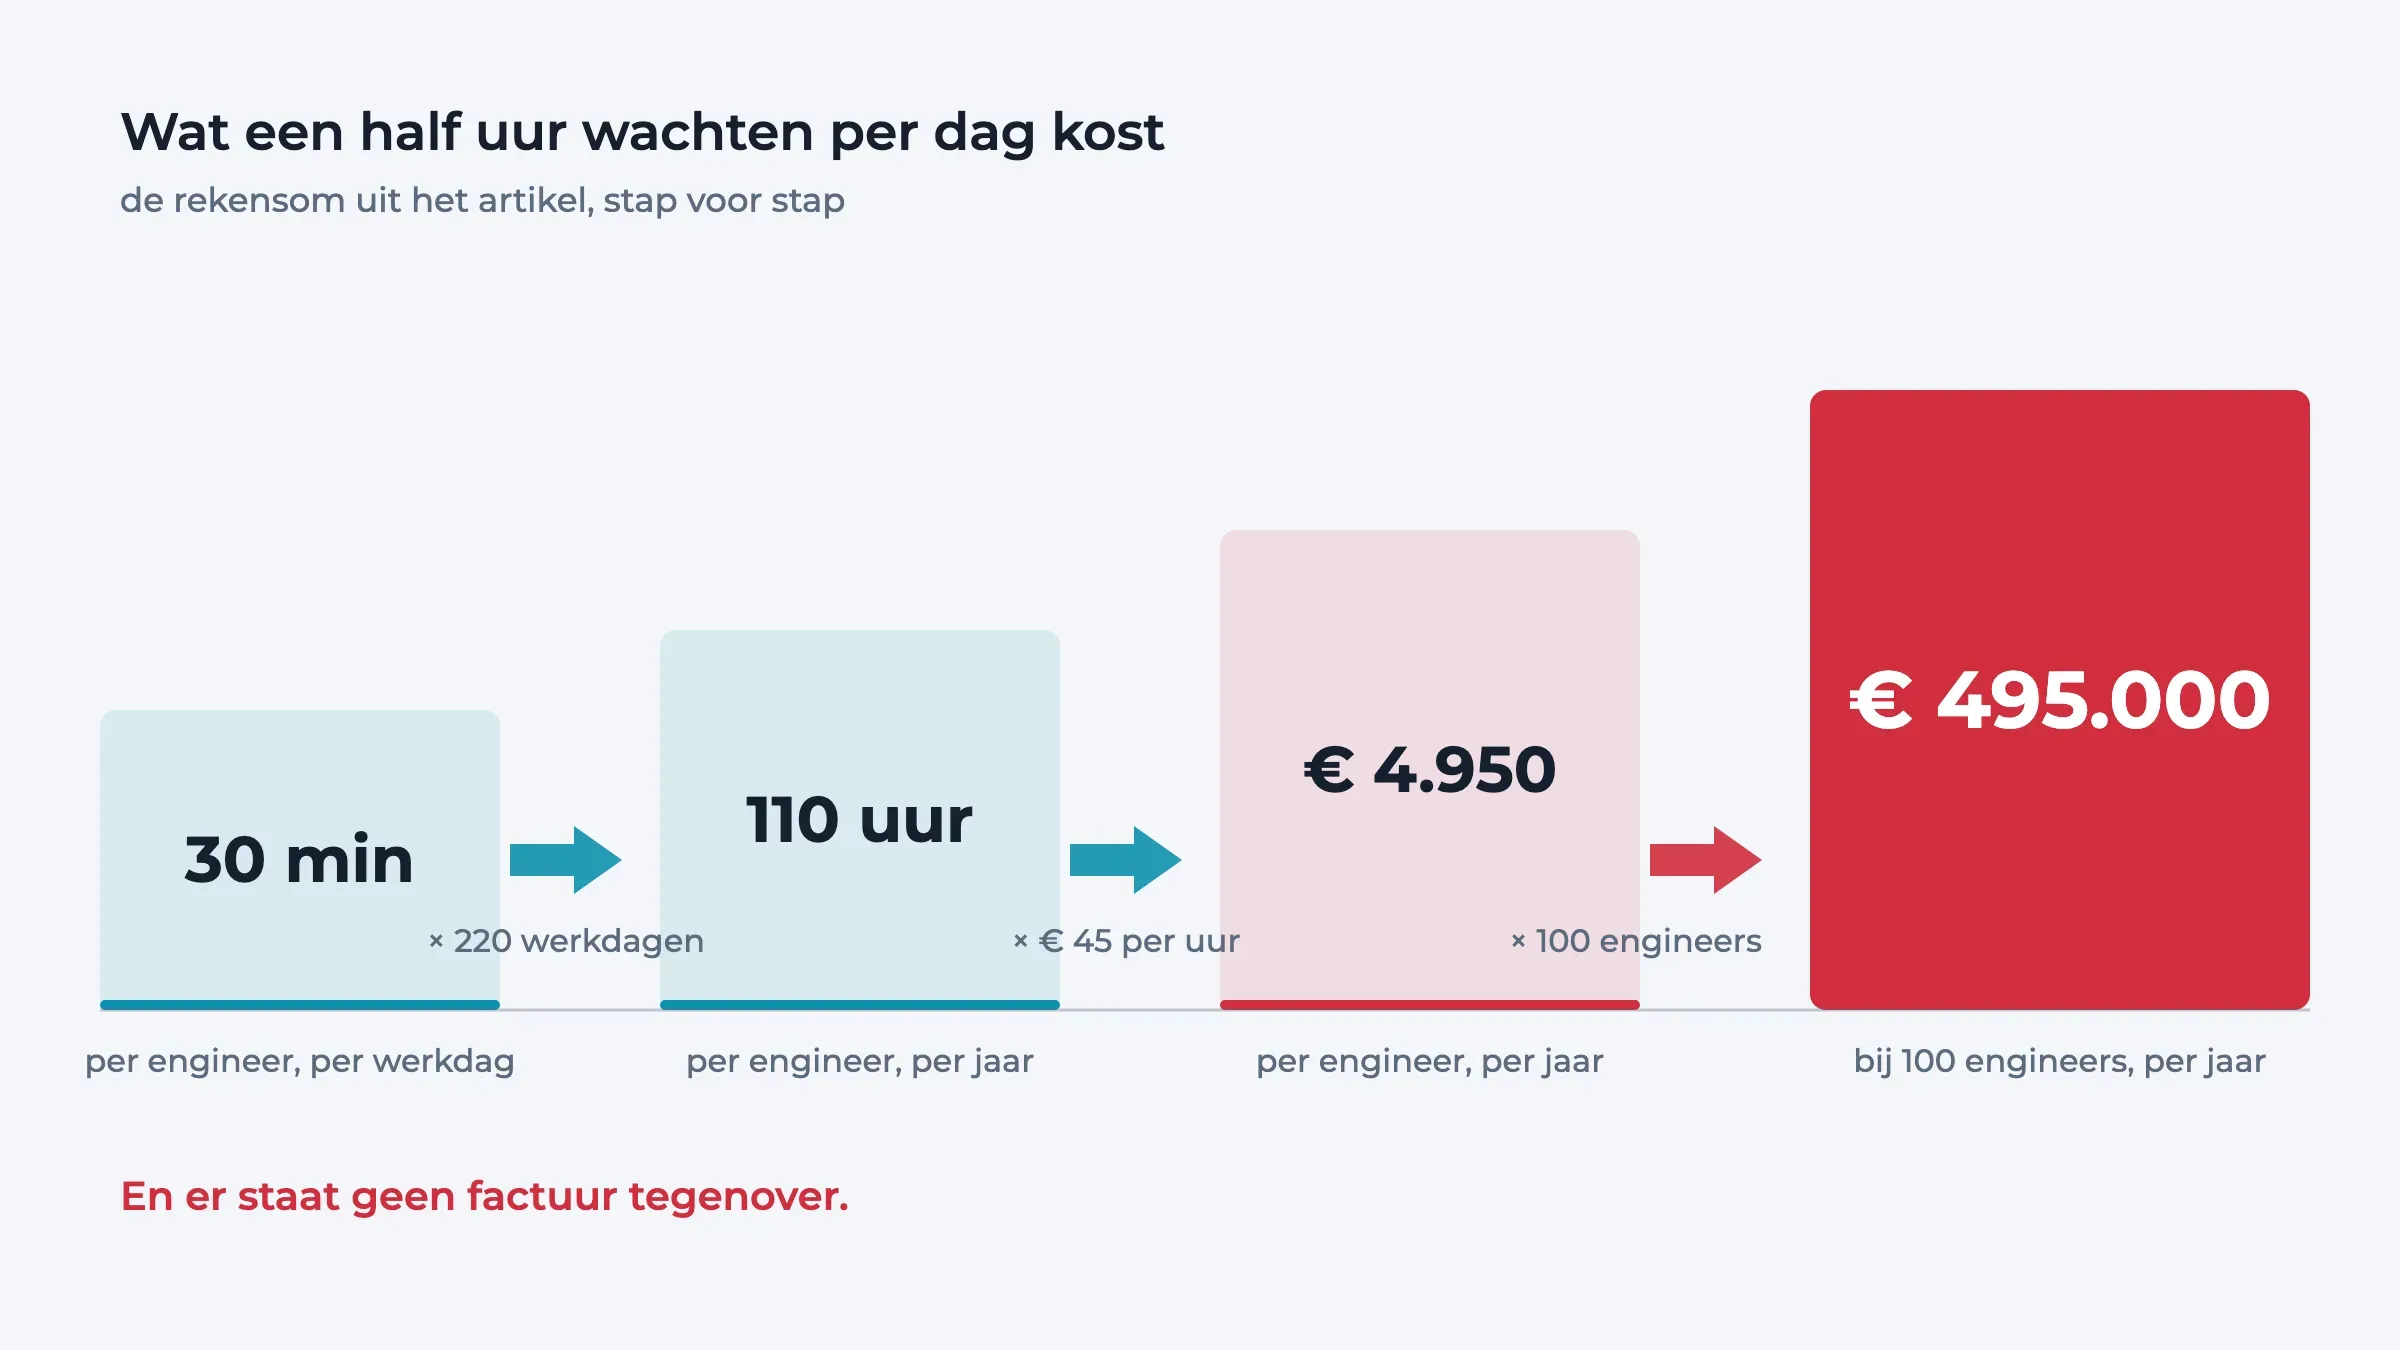
Een half uur per dag, zo weinig lijkt het. Maar reken het door en het is €5.000 per engineer per jaar, of een half miljo...