De oud-baas van GitHub wil van de pull request af. Maar kan je eigen pipeline dat niet ook?
Thomas Dohmke, tot augustus 2025 CEO van GitHub, lanceerde op 26 oktober 2026 Entire: een alternatief voor GitHub en GitLab dat de pull request vervangt door iets wat hij een Trail noemt. Is dat een revolutie, of een duur antwoord op iets wat een betere pipeline ook oplost?
Dohmke, over wiens vertrek we eerder schreven, haalde er in februari 60 miljoen dollar voor op. Git zelf blijft gewoon, en onze lezing is dat dat een bewuste wig is: je kunt een repo vanuit GitHub mirroren, Trails bovenop je bestaande pull requests draaien en later helemaal verhuizen. Niemand hoeft Git op te geven, en GitHub kan stukje bij beetje overbodig worden.
Een review die moet convergeren
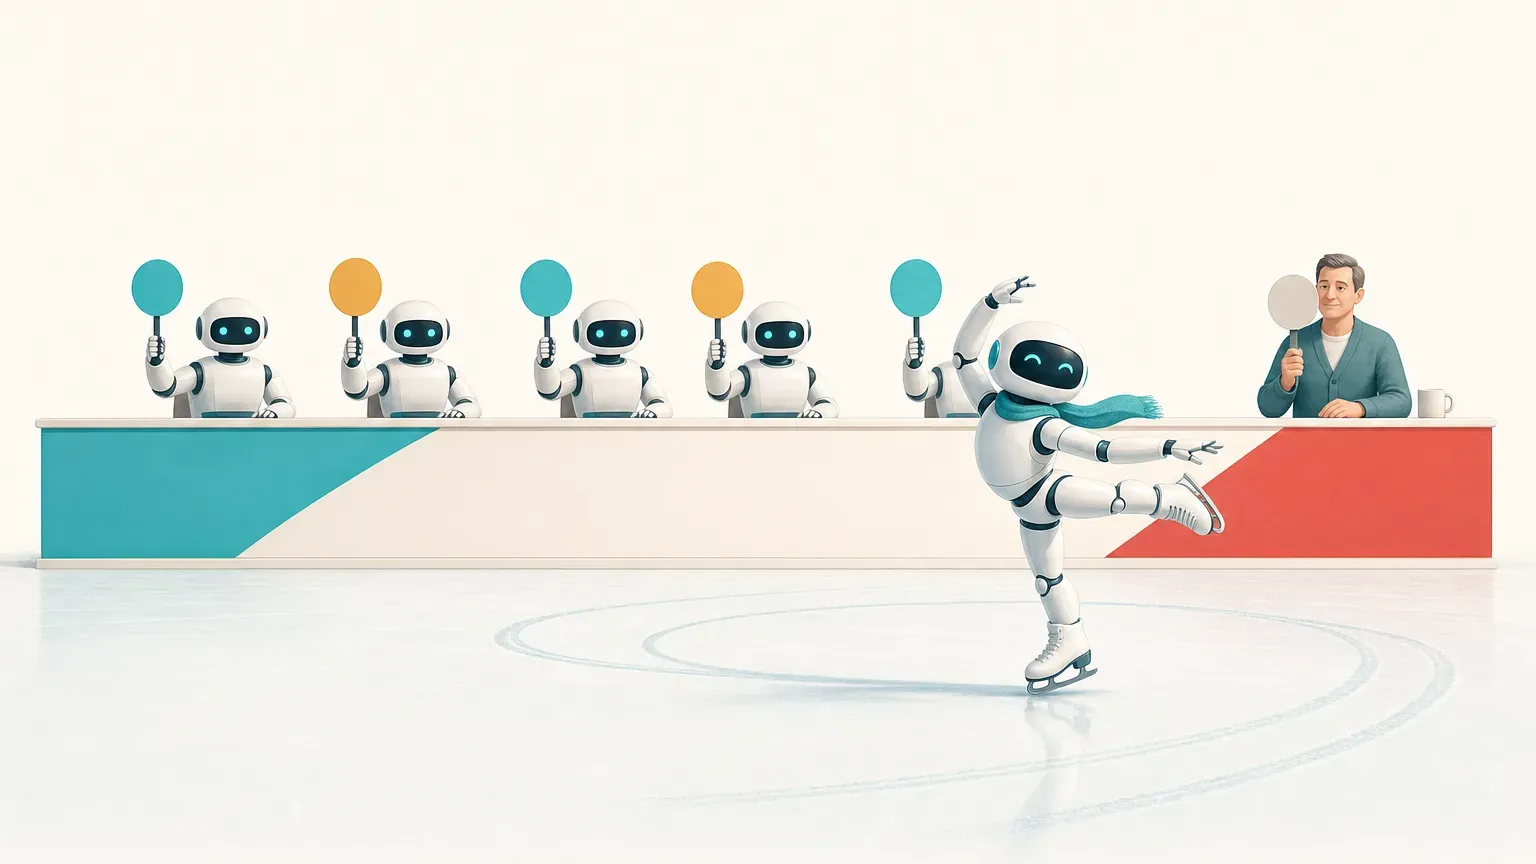
Stel je een merge request voor waarin drie review agents reageren, de coding agent hun commentaar verwerkt en opnieuw pusht, en de agents weer reageren. Als Femke, de tech lead, er donderdagochtend naar kijkt, scrolt ze door een commentaarlawine waarin ergens halverwege ook twee mensen iets zeiden. Een Trail zet daarom eval-scores bovenaan: geautomatiseerde beoordelingen op één aspect, zoals security of "slop" (slordige, overbodige gegenereerde code), bij elke push opnieuw gegeven door meerdere review agents die los van elkaar scoren. Entire vergelijkt het met de jury bij kunstschaatsen.
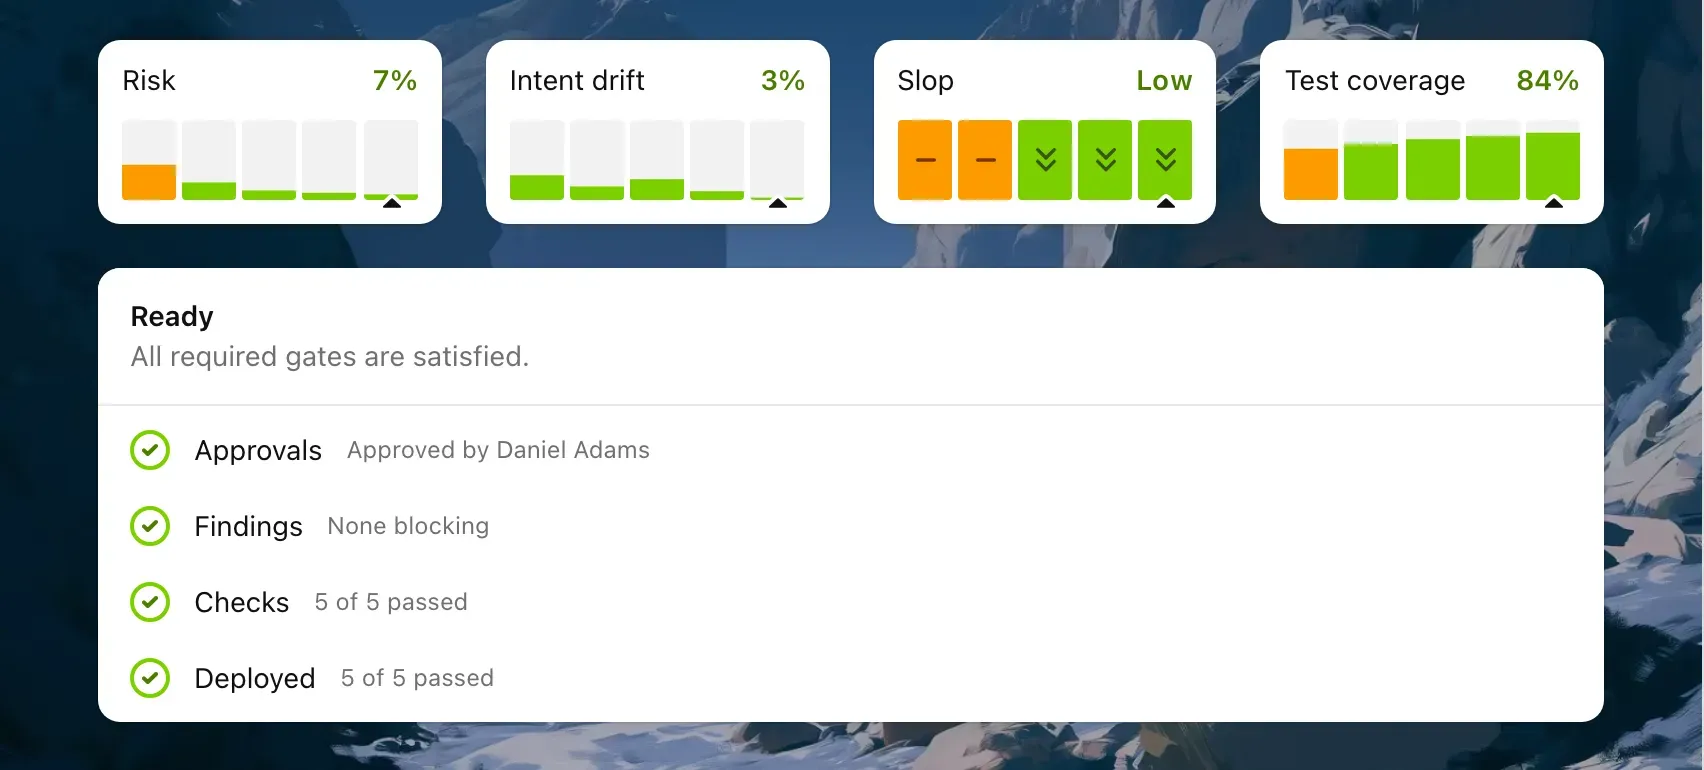
Eval-scores met hun laatste runs, en daaronder de gates. Bron: entire.com.
Dit is volgens ons het echt nieuwe idee: review is geen diff meer die een mens leest, maar een intentie die convergeert tot onafhankelijke beoordelaars het eens zijn. Per eval zie je de laatste vijf runs, dus of een score tot rust komt. Gates, de voorwaarden voor een merge, eisen onder meer menselijke goedkeuring en slagende CI. (Zijstapje: bij echt kunstschaatsen worden de hoogste en laagste jurycijfers geschrapt, omdat juryleden er weleens naast zitten. Of Entire zoiets doet, hebben we niet teruggevonden.)
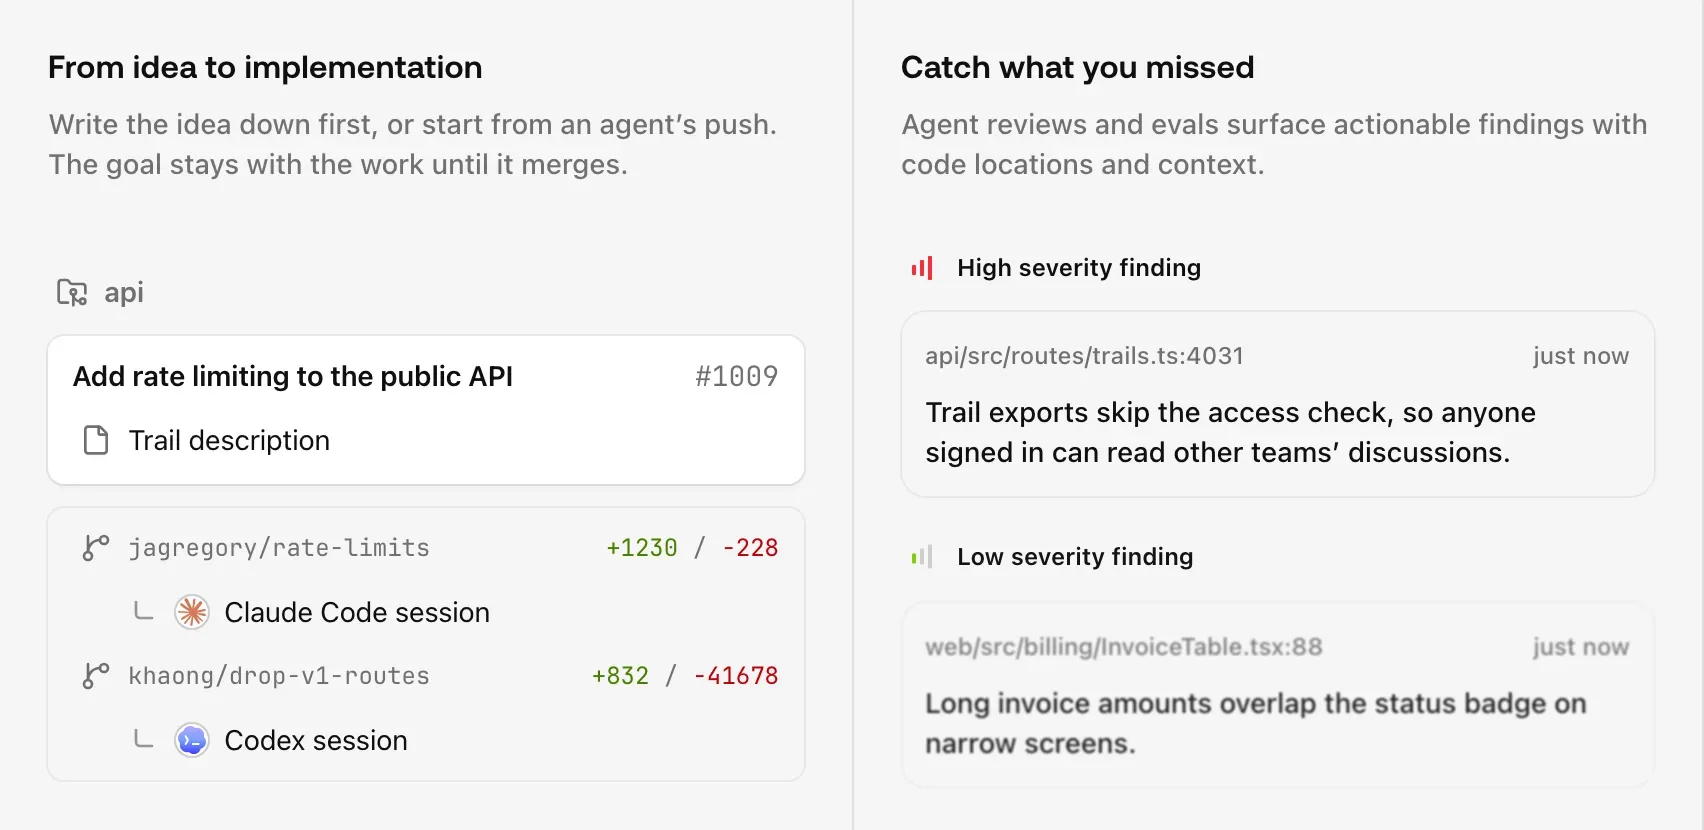
Een Trail die twee branches en twee agentsessies bundelt, met bevindingen per ernstniveau. Bron: entire.com.
Kun je dit niet gewoon in GitLab of GitHub bouwen?
Grotendeels wel. Een CI-job die bij elke push een review agent laat lopen en de score als status check terugzet, is een middag werk. Approval rules en branch protection dwingen menselijke goedkeuring af, en een merge train of merge queue doet de rest. Moeilijker na te bouwen is wat eronder ligt: een blijvend object voor de intentie, werk dat over repositories heen bij elkaar hoort, en bij elke commit de agentsessie en de prompt waar hij uit voortkwam. Of dat genoeg is tegen twee partijen met miljoenen gebruikers, durven we niet te voorspellen.
De snelheidsclaim is het zwakste stuk
Entire zegt dat pushes tot 89 keer sneller zijn dan bij GitHub, gemeten met forgemark, een benchmark die het zelf schreef. Alleen is pushen bij de meeste teams niet de bottleneck. Een push is in seconden klaar; de pipeline en de review duren uren, en soms wacht alles op die ene collega die tot donderdag in workshops zit (zie ook AI maakt code goedkoop. Je organisatie is nog steeds duur). Wie via een mirror bij GitHub blijft, pusht volgens de launchpost bovendien nog steeds via GitHub.
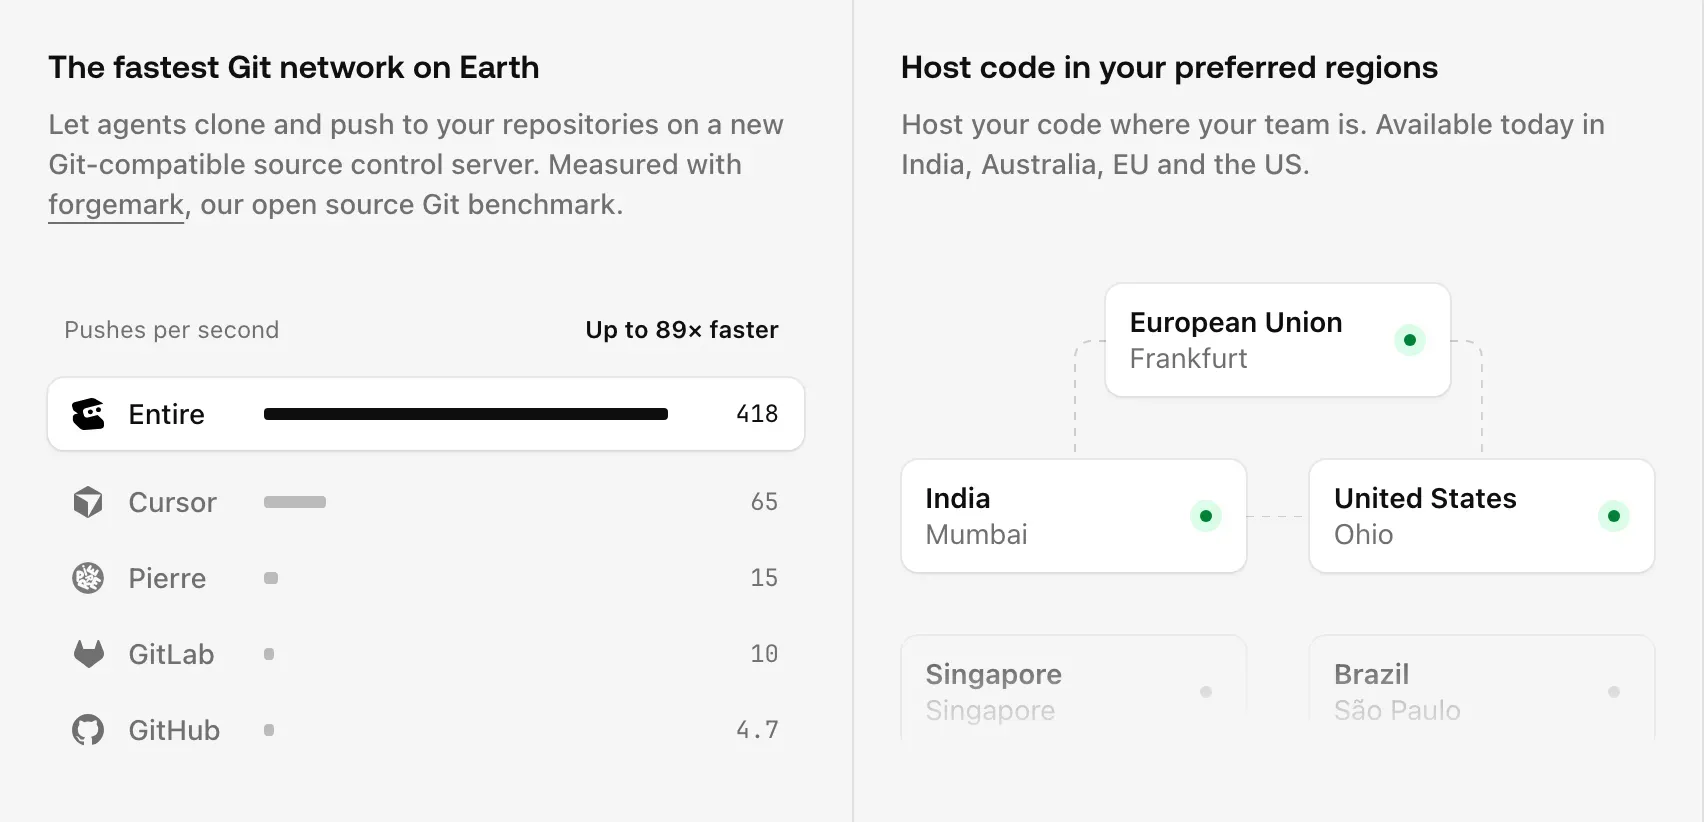
Entires eigen forgemark-meting (GitLab 10, GitHub 4,7 pushes per seconde) en de hostingregio's. Bron: entire.com.
Praktischer is dataresidentie: de EU (Frankfurt) zat er vanaf de lancering bij. Voor wie met de AVG of gereguleerde klanten werkt, doet "onze code staat in Frankfurt" in een aanbesteding meer dan 89 keer sneller pushen.
Wie beoordeelt de jury?
Het grootste risico zit volgens ons in de wet van Goodhart: zodra een maatstaf een doel wordt, deugt hij niet meer als maatstaf. Een agent die doorgaat tot de LLM-judge (een taalmodel als beoordelaar) op groen springt, optimaliseert tegen het oordeel van een ander model, met mogelijk dezelfde blinde vlekken. Vijf stabiele runs bewijzen dan vooral dat de jury het met zichzelf eens is.
De mens gaat dus van diffs lezen naar evals ontwerpen en controleren. En naast een judge-score meet je uitkomsten, zoals de change failure rate (hoe vaak een wijziging in productie misgaat). Google's DORA-onderzoek van 2024 zag de opleverstabiliteit dalen met 7,2% per 25% meer AI-gebruik.
Revolutie, evolutie of weddenschap?
Alle drie. In reviewfilosofie is Entire een revolutie, technologisch een evolutie, en de hosting is een weddenschap die vooral loont voor wie een vloot agents de hele dag laat pushen. Voor de meeste teams is de vraag eerder wat AI met hun change failure rate doet. In Agile Analytics, ons eigen platform, beoordelen we AI-werk daarom op uitkomsten, niet op het aantal gegenereerde regels.
Wil je het Trail-patroon proberen zonder te migreren? Laat een week lang bij elke push een review agent draaien die zijn score als status check zet, leg een paar evals vast als config in de repo, bewaar de laatste vijf runs en houd menselijke goedkeuring verplicht. Wij starten zelf een proof of concept met een agentische ontwikkelomgeving en schrijven op wat eruit komt. Wil je intussen sparren over AI in je ontwikkelproces: een verkenningsgesprek is gratis.
De agent schrijft. Wie reviewt?
AI zet je tempo omhoog en je zekerheid omlaag. Wij helpen je teams snel blijven werken zonder de controle kwijt te raken.
AI consultancy
AI inzetten waar het echt scheelt, met de verantwoordelijkheid bij mensen.
Lees ook:
In 1988 legde een student een tiende van het internet plat. Wat deden we daarna?
In november 1988 schreef een student aan Cornell een programmaatje dat moest tellen hoeveel computers er aan het interne...
Kan Google de AI-race winnen door Open Source te gaan? (waardoor de investering van 10 miljard in OpenAI waardeloos wordt)
Een uitgelekt document van een anonieme Googlemedewerker heeft discussies aangewakkerd over de impact van open-source AI...
"Niet AI pakt je baan af, maar een collega met AI." Welke collega eigenlijk?
Als programmeur verlies je je werk niet aan AI, maar aan een programmeur die wél AI gebruikt. Ik ben het ermee eens. All...
OpenAI's AI-agents braken in bij een ander bedrijf. Waarom noemen we dat opeens een complot?
OpenAI's AI-agents braken deze zomer in bij Hugging Face, een ander AI-bedrijf. Volgens Dwarkesh Patel was het een AI-be...
Een AI-abonnement van 200 dollar levert 14.000 dollar aan rekenkracht op. Maar klopt die som?
Een ChatGPT Pro-abonnement van 200 dollar zou 14.000 dollar per maand aan rekenkracht opleveren. Zo gaat de screenshot r...
Mijn AI agent werkt 's nachts voor me door. Hij mag alleen niks beslissen.
Sinds augustus draait bij ons elke werkdag om half acht een agent die de open merge requests leest en er iets van vindt....